Repenser la détection non supervisée d'anomalies réseau : quand un protocole rigoureux fait tomber les scores parfaits
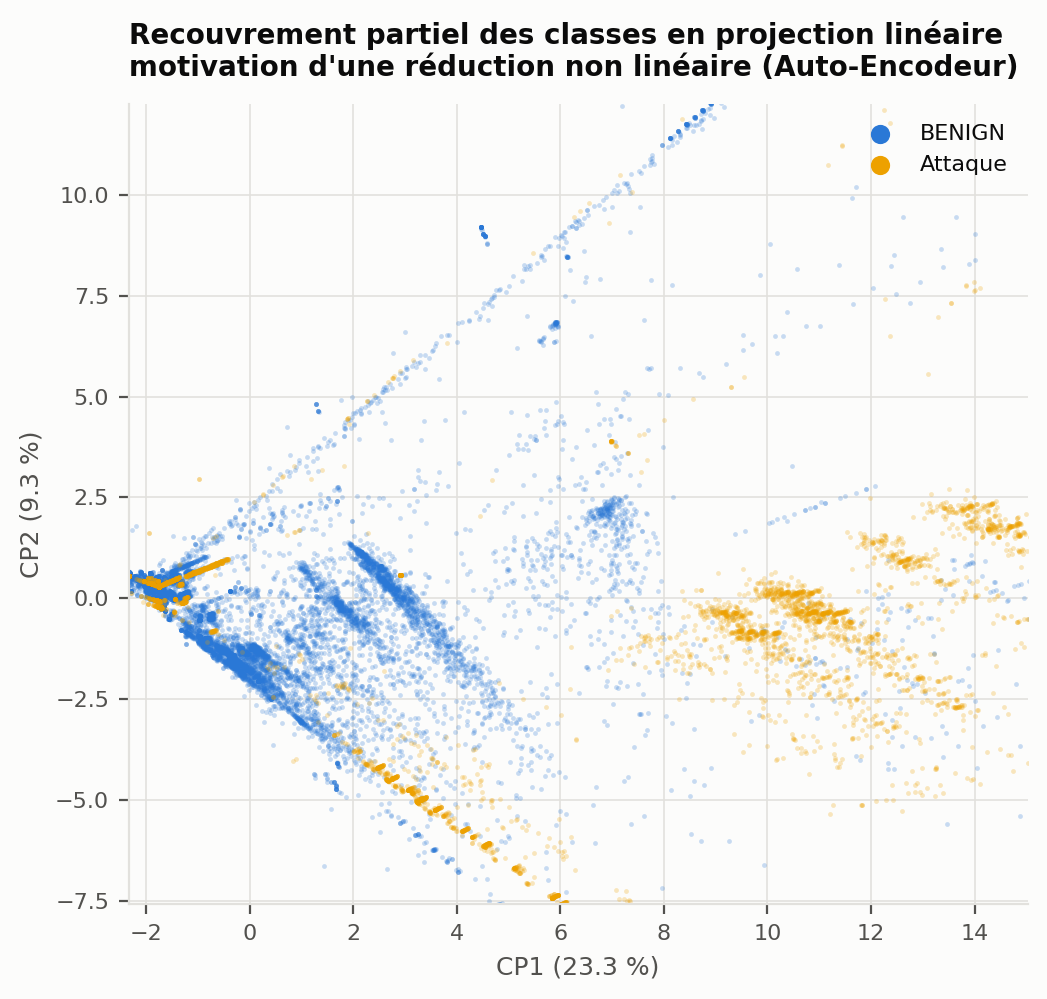
En résumé : évaluée sous un protocole sans fuite d'information sur CICIDS2017, l'architecture Auto-Encodeur + Isolation Forest atteint une performance réelle modeste (PR-AUC ≈ 0,70), loin des scores quasi parfaits souvent rapportés. Trois enseignements ressortent : 99,6 % des flux malveillants sont identifiables par la seule adresse IP source, la réduction non linéaire de l'auto-encodeur ne bat pas une simple ACP, et le trafic normal dérive au fil de la semaine au point d'invalider tout seuil fixe.
Pourquoi ce travail
L'augmentation du volume de trafic et la sophistication des attaques, en particulier de type zero-day, exposent les limites des systèmes de détection fondés sur des signatures ou sur des modèles supervisés dépendants de données annotées. Les approches non supervisées promettent de détecter l'inconnu sans étiquettes, et l'architecture hybride Auto-Encodeur + Isolation Forest est régulièrement présentée comme performante pour ce problème.
Ce travail est né d'un inconfort méthodologique simple : les scores quasi parfaits rapportés sur le jeu CICIDS2017 ne concordent pas avec la difficulté intrinsèque de détecter des anomalies sans étiquettes. Plutôt que de prendre ces chiffres pour acquis, nous les avons soumis à un protocole délibérément plus strict. Les résultats sont moins spectaculaires, et bien plus instructifs.
Un jeu de données à manier avec prudence
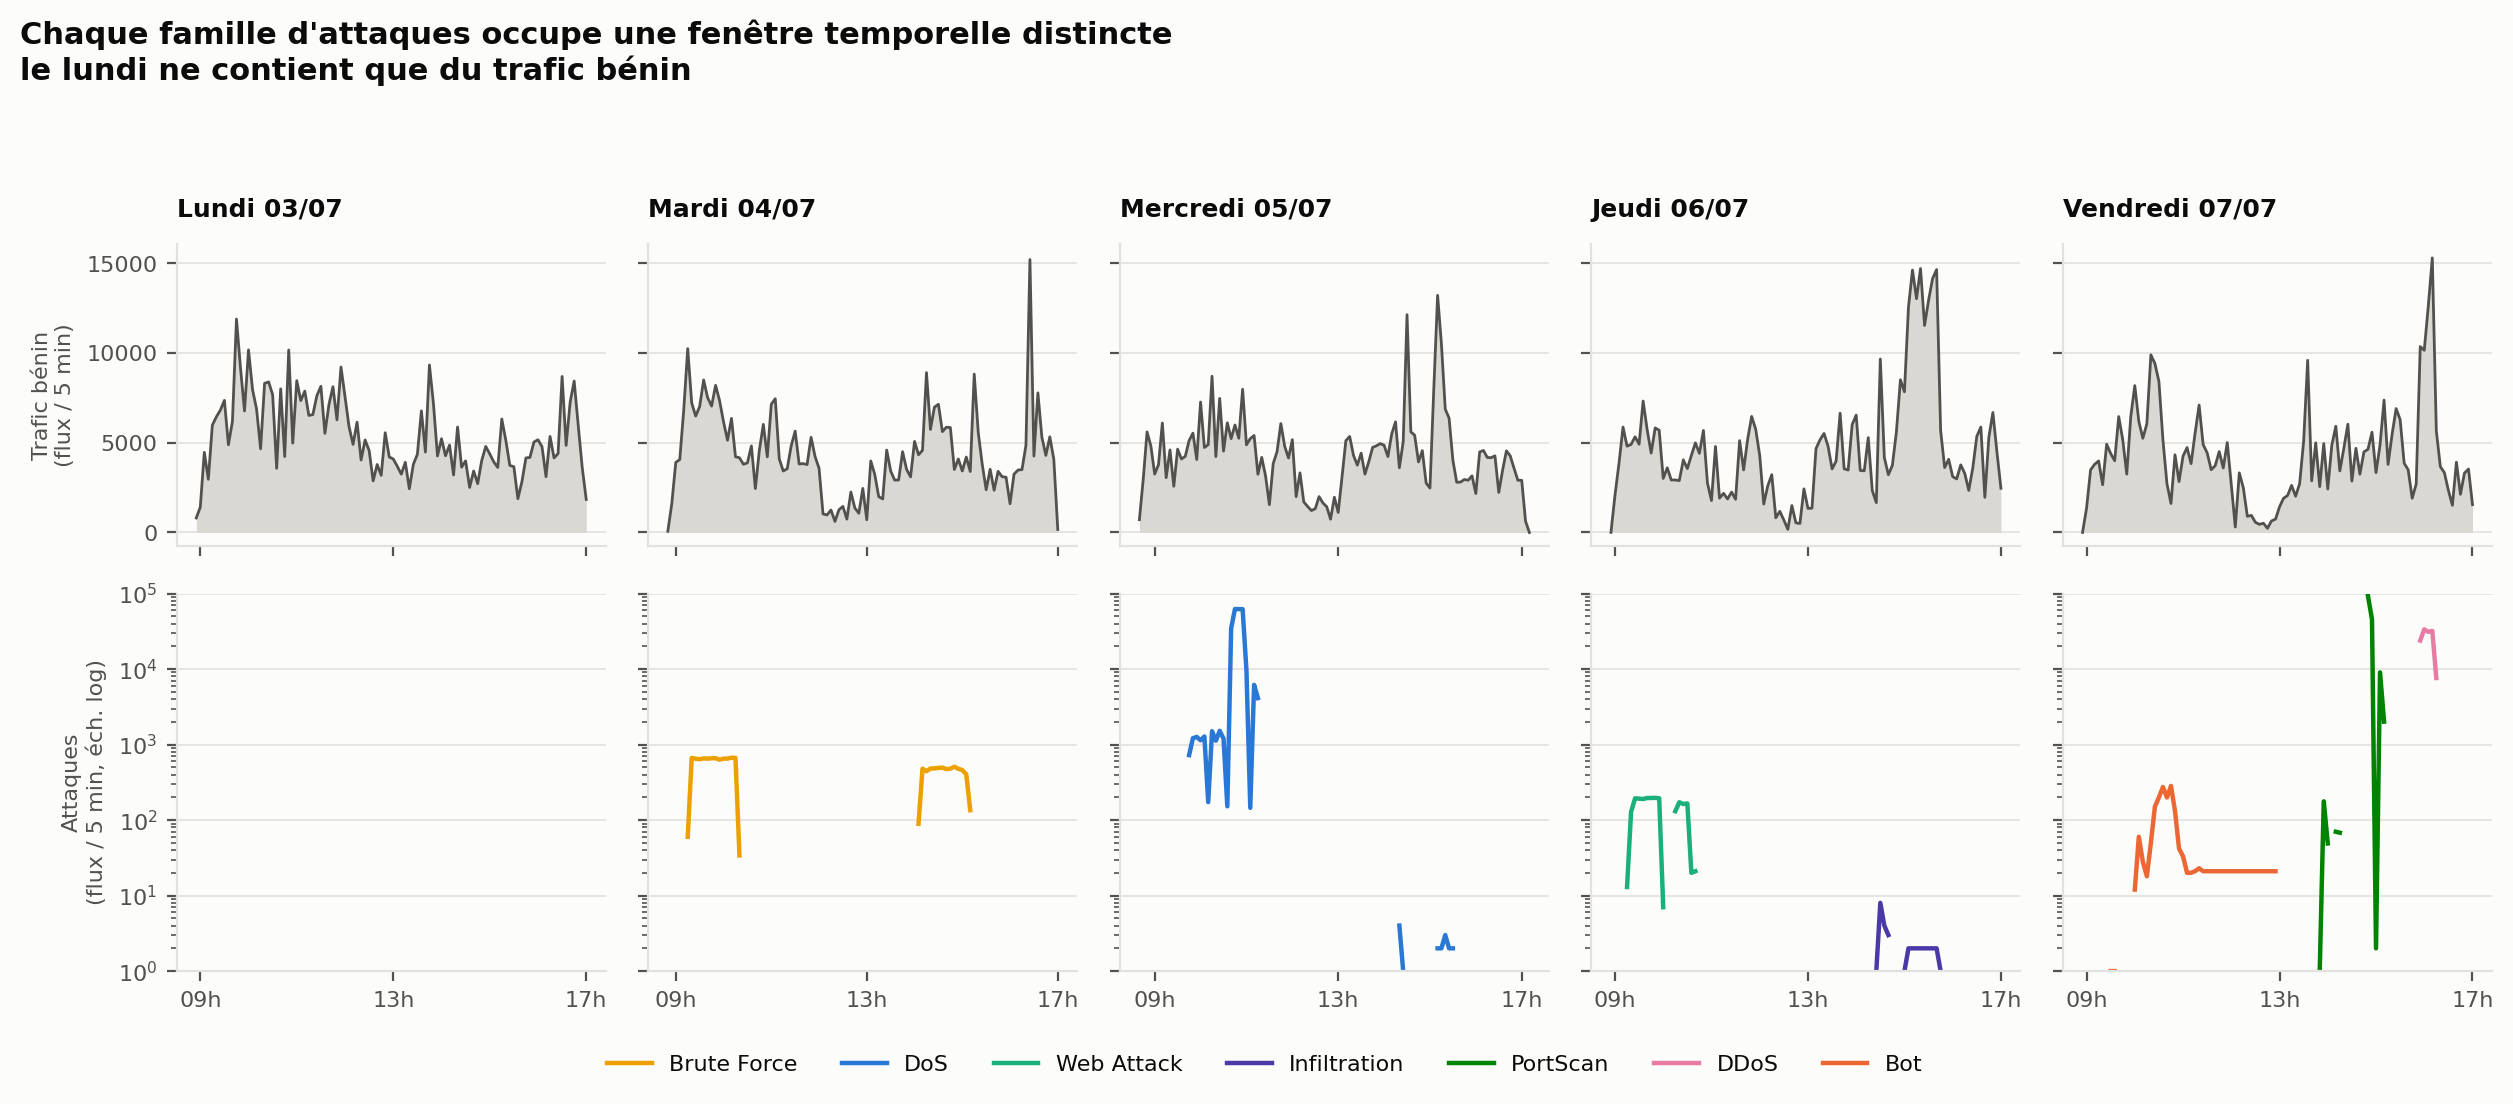
CICIDS2017 reproduit cinq journées ouvrées de trafic, du lundi au vendredi. Chaque famille d'attaques occupe une fenêtre temporelle distincte, et le lundi ne contient aucun flux malveillant, ce qui fournit directement un ensemble d'apprentissage bénin pur. Le jeu compte 2 830 743 flux, dont 80,3 % de trafic bénin, mais son exploitation naïve est piégée : lignes entièrement vides, encodages incohérents, horodatages sur douze heures sans marqueur AM/PM qui faussent l'ordre chronologique.
Résultat 1 : la fuite par les identifiants
L'analyse du pouvoir prédictif des colonnes est sans appel. L'information mutuelle entre l'adresse IP source et l'étiquette atteint 0,486, contre 0,334 pour la meilleure caractéristique comportementale (Average Packet Size). Plus frappant encore, 99,64 % des flux malveillants proviennent d'une seule et même adresse IP source.
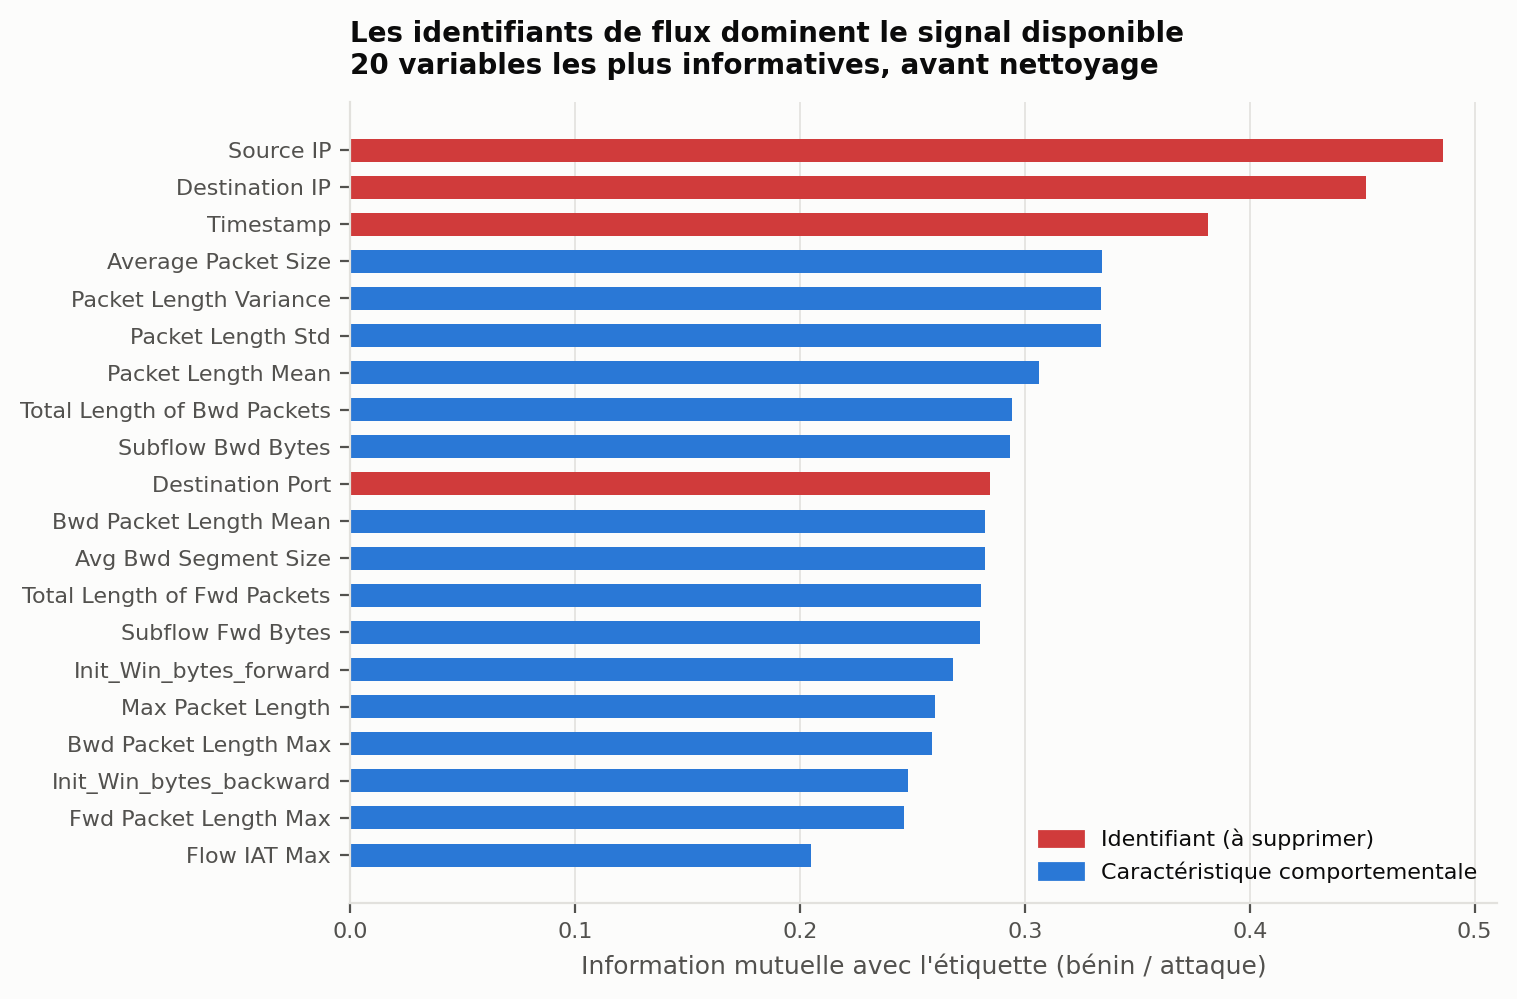
Une règle triviale « si l'IP source vaut X, alors attaque » atteint un rappel supérieur à 0,99 sans rien apprendre du comportement réseau. Conserver ces colonnes revient à mesurer la mémorisation du banc d'essai, pas la détection d'anomalies. Nous supprimons donc Flow ID, Source IP, Destination IP, Source Port et Timestamp.
Un protocole d'évaluation sans fuite
Nous appliquons trois garde-fous : suppression des identifiants, déduplication exacte effectuée avant la séparation (330 766 doublons retirés), et séparation strictement temporelle. La normalisation est ajustée une seule fois, sur le seul trafic bénin d'entraînement, puis appliquée aux autres ensembles. Il reste 66 variables d'entrée.
| Ensemble | Origine | Bénin | Attaques | Usage |
|---|---|---|---|---|
| Entraînement | Lundi (80 %) | 394 017 | 0 | Apprentissage |
| Validation | Lundi (20 %) | 98 504 | 0 | Calibration du seuil |
| Test | Mardi à vendredi | 1 578 881 | 425 593 | Évaluation finale |
Résultat 2 : le latent non linéaire ne gagne pas
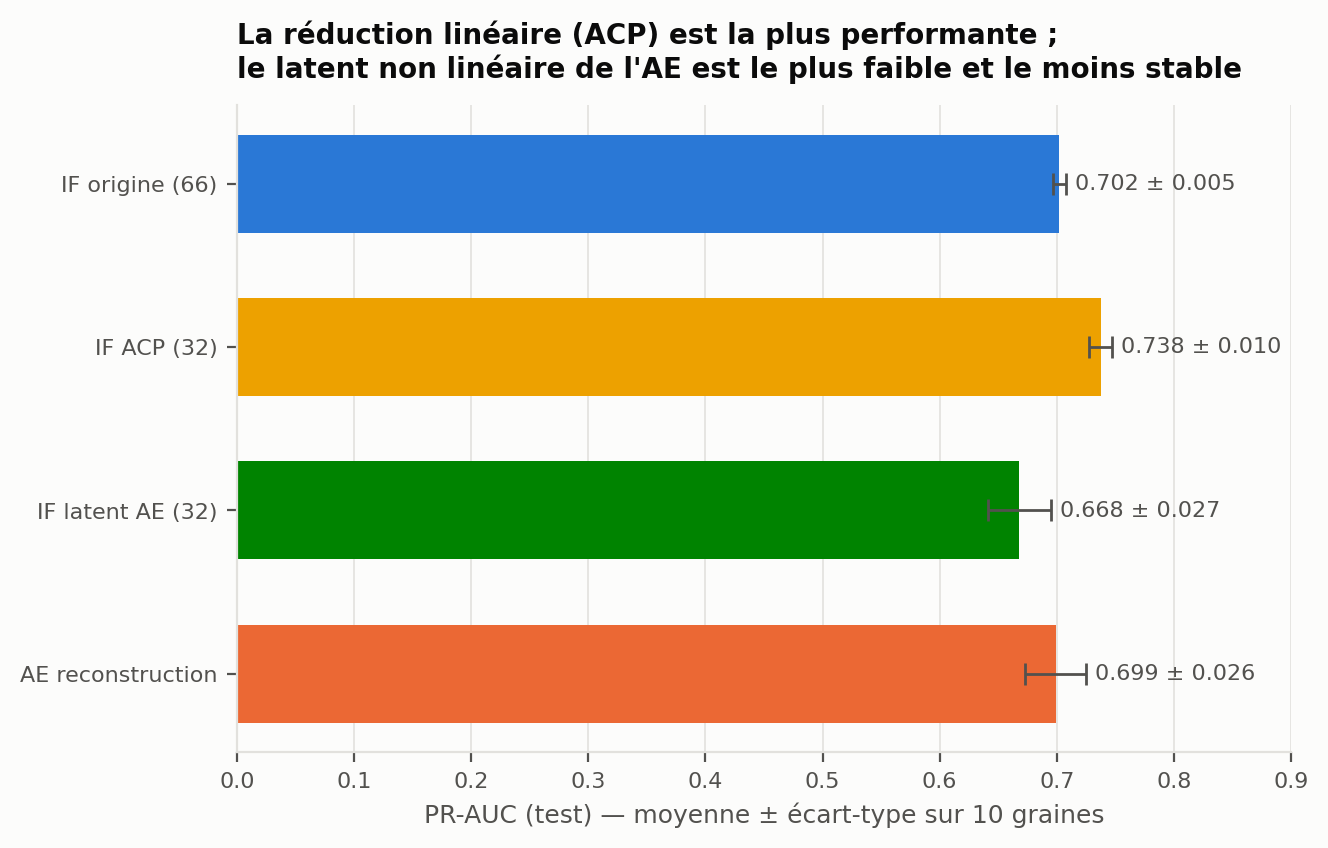
Sur dix exécutions indépendantes, nous comparons l'Isolation Forest appliqué à trois représentations, plus l'erreur de reconstruction de l'auto-encodeur. Le constat surprend : la projection dans l'espace latent non linéaire est la représentation la moins performante et la moins stable. Une simple réduction linéaire par analyse en composantes principales (ACP) fait significativement mieux (Δ = +0,069, d de Cohen = 2,1, p = 0,012 après correction).
| Méthode | PR-AUC | ROC-AUC |
|---|---|---|
| Isolation Forest, ACP (32) | 0,738 ± 0,010 | 0,946 ± 0,003 |
| Isolation Forest, variables d'origine (66) | 0,702 ± 0,005 | 0,949 ± 0,001 |
| Auto-encodeur, erreur de reconstruction | 0,699 ± 0,026 | 0,937 ± 0,004 |
| Isolation Forest, latent AE (32) | 0,668 ± 0,027 | 0,930 ± 0,009 |
L'explication tient à l'objectif d'entraînement : un auto-encodeur apprend à reconstruire, pas à séparer. Son espace latent optimise la fidélité de compression du trafic normal, sans garantie que les attaques y deviennent plus isolables, là où l'ACP préserve justement les axes de plus grande variance, ceux qui portent les écarts volumétriques caractéristiques de la plupart des attaques.
Calibrer le seuil sur le trafic bénin
Un score d'anomalie n'est pas une décision : il faut un seuil. Plutôt que de supposer connue la proportion d'attaques, nous calibrons le seuil sur un quantile des scores du trafic bénin de validation. Le paramètre α, le taux de fausses alarmes toléré, devient alors un réglage opérationnel direct : le budget d'alertes qu'un centre de sécurité peut absorber.
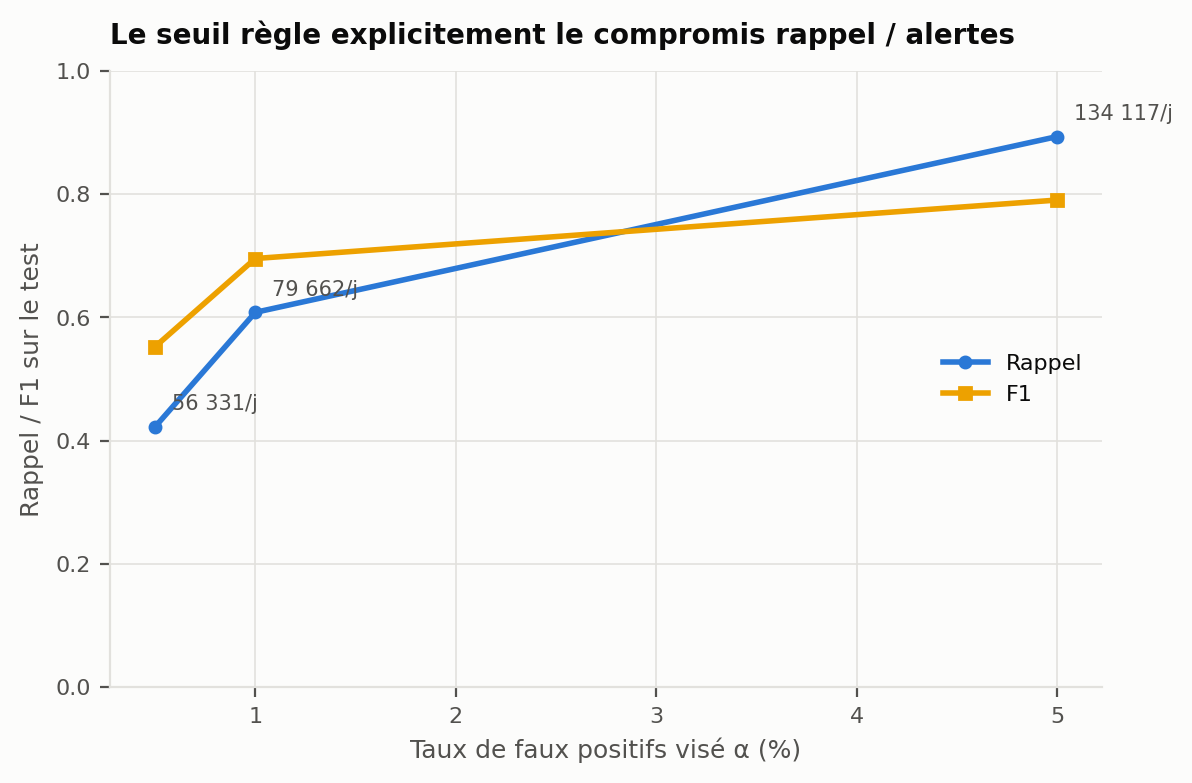
| α visé | Seuil τ | TFP réel | Rappel | Précision | F1 | Alertes/jour |
|---|---|---|---|---|---|---|
| 5 % | 0,00094 | 9,9 % | 0,893 | 0,709 | 0,790 | 134 117 |
| 1 % | 0,00254 | 3,8 % | 0,608 | 0,812 | 0,695 | 79 662 |
| 0,5 % | 0,00333 | 2,9 % | 0,422 | 0,798 | 0,552 | 56 331 |
Résultat 3 : le trafic normal dérive
La calibration sur le lundi suppose un trafic normal stable les jours suivants. La séparation temporelle permet de vérifier cette hypothèse, ce qu'un découpage aléatoire rend impossible. L'erreur de reconstruction moyenne du trafic bénin est multipliée par près de cinq entre le mardi et le vendredi, et l'indice de stabilité de population (PSI) franchit le seuil de dérive dès le jeudi.
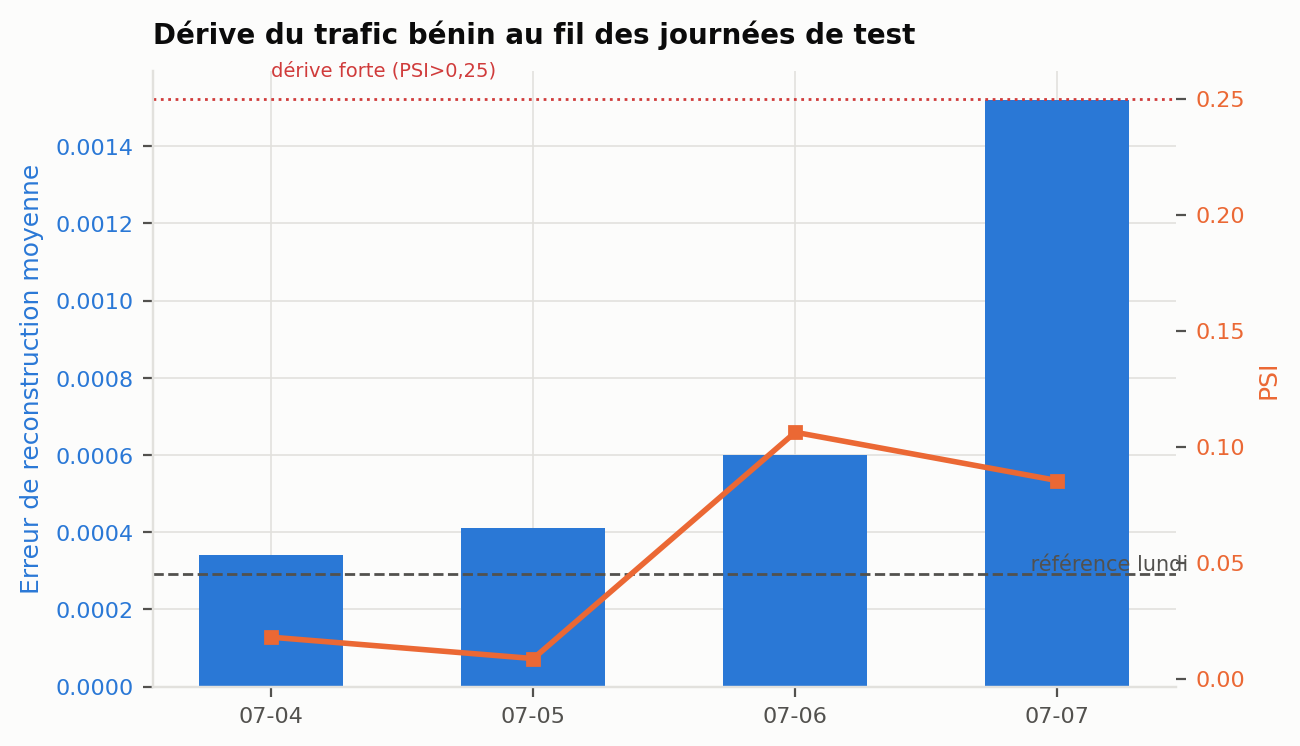
Cette dérive explique directement pourquoi le taux de faux positifs réel (3,8 %) dépasse la cible (1 %) : le seuil calibré le lundi sous-estime les scores des jours suivants. Un seuil fixé une fois pour toutes est structurellement insuffisant ; la recalibration périodique n'est pas un raffinement optionnel mais une nécessité mise en évidence par les données elles-mêmes.
Ce que la méthode détecte, et ce qui lui échappe
Le profil de détection est cohérent avec la nature de l'approche : les attaques volumétriques, qui s'écartent nettement du trafic normal par le volume et le débit, sont majoritairement détectées ; les attaques furtives, qui imitent des sessions légitimes, échappent presque entièrement au détecteur.
| Famille d'attaques | Flux (test) | Rappel |
|---|---|---|
| DoS (Hulk, GoldenEye, slowloris…) | 193 597 | 0,764 |
| PortScan | 90 694 | 0,600 |
| DDoS | 128 014 | 0,438 |
| Bot | 1 948 | 0,102 |
| Attaque Web (Brute Force, XSS, SQLi) | 2 143 | 0,041 |
| Force brute (FTP, SSH-Patator) | 9 150 | 0,000 |
Des alertes explicables, sans coût additionnel
Un détecteur déployé doit justifier ses alertes. L'auto-encodeur fournit cette explication gratuitement : pour chaque flux alerté, le résidu de reconstruction par variable désigne les caractéristiques les plus responsables de l'écart au comportement normal. Une alerte DoS Hulk est ainsi portée par un drapeau FIN inattendu et une irrégularité des temps d'inter-arrivée, une alerte DDoS par une taille de paquet anormalement élevée. Cette explication reste descriptive : elle désigne les variables anormales sans établir de lien causal formel.
Ce que nous en retenons pour la pratique
La valeur d'un système de détection ne réside pas dans un score record, mais dans son honnêteté opérationnelle : un seuil au sens explicite, des alertes explicables, et une surveillance de la dérive qui répond à un phénomène réel mesuré dans les données. Ces trois exigences, calibration adaptative, explicabilité et suivi de la dérive, sont précisément celles que nous plaçons au cœur de nos systèmes de détection.
Au-delà de la méthode, ce travail plaide pour que les évaluations en détection d'intrusion soient conduites avec la même rigueur que les architectures. Sans contrôle des fuites, de la redondance et de la structure temporelle, les performances rapportées mesurent le banc d'essai plutôt que la capacité réelle de détection.
L'ensemble du code et des artefacts permet de reproduire exactement les résultats. Un résultat négatif rigoureux vaut mieux qu'un score parfait qui ne survit pas au contact du réel.